章节大纲
-
-
-
-
update(x) = 1 + 1/x能收敛到黄金比例,不是所有方程随便写成 \(x=f(x)\) 迭代就会收敛;不动点迭代有严格收敛条件。1. 回顾:我们在做不动点迭代
我们的方程:
\(\phi^2=\phi+1 \implies \phi = 1+\frac1\phi\) 定义迭代函数
\(f(x)=1+\frac1x\) 迭代:\(x_{n+1}=f(x_n)\) 求不动点:\(x=f(x)\)
不动点:输入 x,经过 f 变换后输出仍然等于 x。
2. 不动点收敛定理(Banach 不动点 / 导数判据,一维简单版)
设 \(x^*\) 是不动点 \(x^*=f(x^*)\)。 如果在不动点附近满足:
\(\boldsymbol{|f'(x^*)| < 1}\) 那么从足够靠近 \(x^*\) 的初始值出发,迭代 \(x_{n+1}=f(x_n)\) 局部收敛; 如果 \(|f'(x^*)|>1\),局部发散。
直观理解:导数绝对值小于 1,每次迭代误差会被 “压缩”;大于 1,误差被放大,越迭代越远。
套入黄金比例例子
\(f(x)=1+\frac1x\) 求导:
\(f'(x) = -\frac{1}{x^2}\) 不动点 \(x^*=\phi=\frac{1+\sqrt5}{2}\approx1.618\)
\(|f'(\phi)|=\left|-\frac{1}{\phi^2}\right|=\frac{1}{\phi^2}\) 我们知道 \(\phi^2=\phi+1\approx2.618\)
\(\frac{1}{\phi^2}\approx0.382<1\) ✅ 满足 \(|f'(\phi)|<1\) → 局部收敛。 这就是为什么
golden_update能不断逼近 phi。 负号代表:迭代值会在 phi 上下震荡,慢慢靠近(你前面看到的序列:1 →2→1.5→1.6667→1.6→1.625… 来回跳,振幅越来越小)。3. 换成别的方程,还成立吗?
不成立!随便改写方程得到的 \(x=f(x)\) 很容易发散。
举同一个二次方程 \(\boldsymbol{x^2-x-1=0}\),我们换一种变形,构造另一个 update: 原方程:\(x^2 = x+1\) 变形方案 2:\(x=x^2-1\) 此时迭代函数 \(f(x)=x^2-1\),不动点同样满足 \(x=x^2-1\),解依然是\(\phi\)。
求导:\(f'(x)=2x\),在不动点\(\phi\approx1.618\)处
\(f'(\phi)=2\times1.618\approx3.236\)
\(|f'(\phi)|>1\) 👉 迭代会发散! 试一下,初始 guess=1: \(x_0=1\) \(x_1=1^2-1=0\) \(x_2=0^2-1=-1\) \(x_3=(-1)^2-1=0\) 陷入循环震荡,永远到不了 1.618。
同一个方程,不同代数变形得到不同迭代函数,有的收敛、有的不收敛。能不能收敛看不动点处导数绝对值。
4. 更多例子对比
- \(f(x)=\cos x\),不动点 \(x=\cos x\)。 \(f'(x)=-\sin x\),不动点附近\(|f'(x)|<1\),迭代收敛。
- \(f(x)=2x+1\),不动点 \(x=2x+1 \Rightarrow x=-1\)。 \(f'(x)=2, |f'|>1\),迭代发散。
5. 两个重要局限
- 局部收敛:只保证起点离根不远时收敛;如果初始 guess 离太远,依然可能发散。黄金比例这个迭代还好,正数起点基本都能收敛。
- 条件 \(|f'(x^*)|<1\) 是充分条件不是必要条件;少数情况导数 = 1 也可能收敛,但非常特殊。
6. 回到代码的结构
improve(update, close, guess=1)improve本身是通用迭代模板,它不管 update 会不会收敛!improve只是机械循环:不断执行update直到close返回 True。- 如果 update 收敛:正常拿到解;
- 如果 update 发散:死循环,永远不满足 close,程序卡住。
模板是中立工具;收敛性完全由你传入的 update 函数决定。
7. 补充:和牛顿法对比(拓展)
不动点迭代收敛速度一般比较慢;牛顿法是一种构造特殊 update 的不动点,保证更快收敛。
小结
golden_update收敛根源:迭代函数 \(f(x)=1+1/x\) 在不动点\(\phi\)处导数绝对值\(<1\),误差逐轮压缩。- 同一个代数方程,可以写成多种 \(x=f(x)\) 形式;只有满足导数判据的那个 update 才能收敛。
improve只是高阶函数循环框架,没有内置收敛保证,给它一个发散的 update 就会死循环。
-
1. 100000 项级数相加
summation(     1, pi_term) = 2.6666666667
summation(    10, pi_term) = 3.0916238067
summation(   100, pi_term) = 3.1365926848
summation(  1000, pi_term) = 3.1410926536
summation( 10000, pi_term) = 3.1415426536
summation(100000, pi_term) = 3.1415876536
真实 π                    = 3.1415926536
这就是
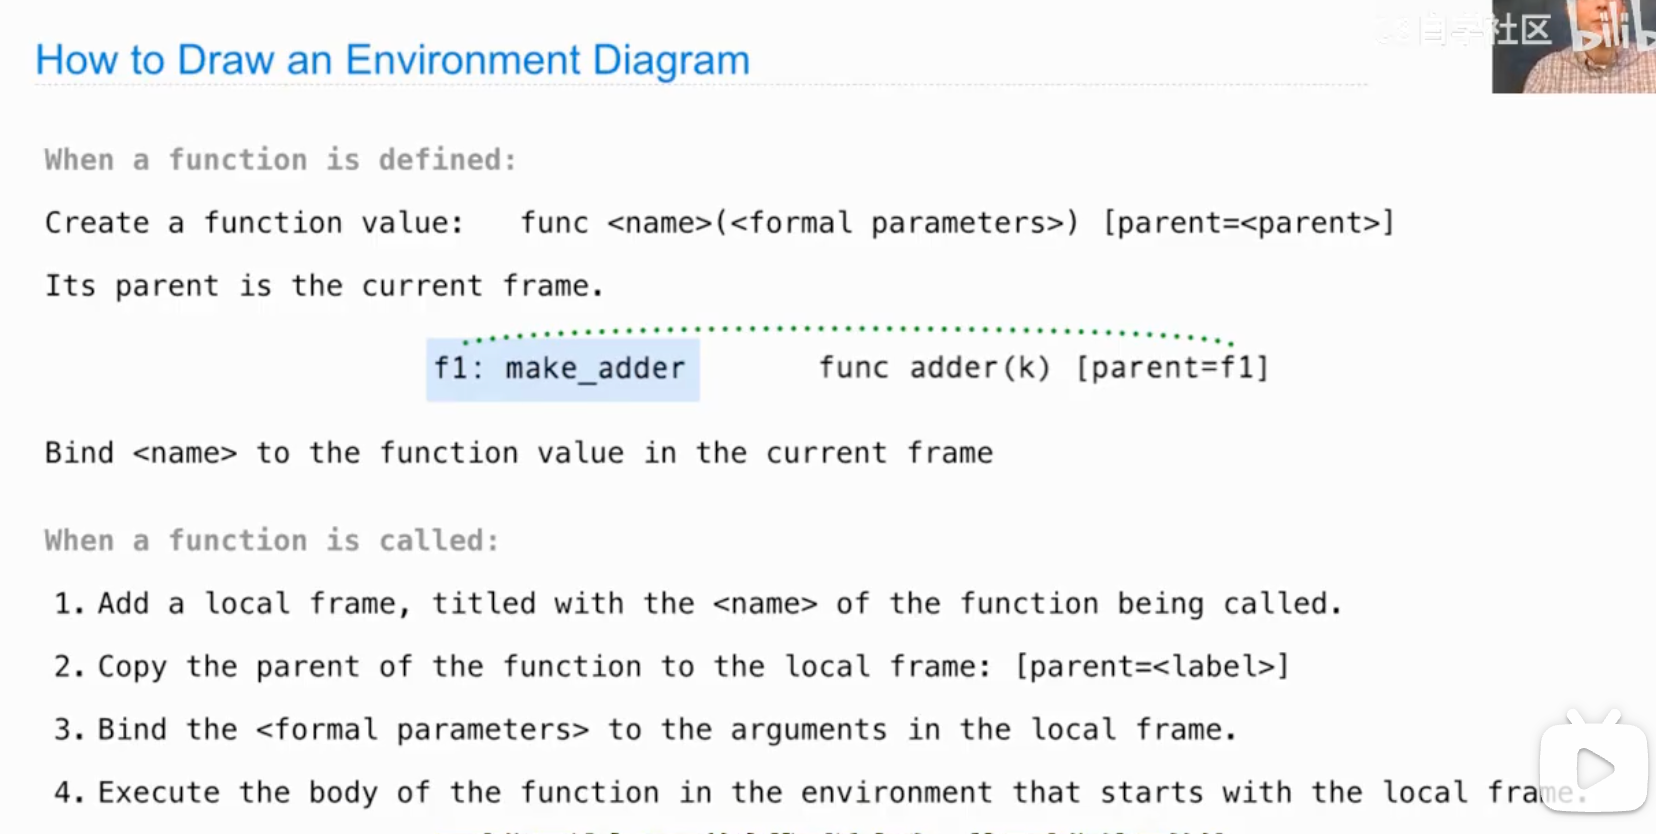
summation的威力——你传多少项它就算多少项,10 万项也只是循环多转几圈。视频里字幕说 "Let's sum a million terms" 就是这个意思。2. make_adder 和 pi_term 的关系
它们不是互相调用的关系,而是同一种角色(term)的不同实现:
summation 是一个"消费函数",它吃进去任何 term(k) -> number 的函数

  pi_term(k)  -> 算π的第k项       (手写好的 term)
  identity(k) -> 返回k本身         (手写好的 term)
  cube(k)     -> 返回k³           (手写好的 term)
  make_adder(3)(k) -> 返回k+3     (用工厂现造的 term)
它们都长一个样子:输入一个 k,输出一个数。所以都能传给
summation。刚才验证了最后一行:
summation(10, make_adder(3))  # = 85
# 等于 (1+3)+(2+3)+...+(10+3) = 4+5+...+13 = 85
那 make_adder 到底比 pi_term 多了什么?
pi_term 是写死的——常数 8、4k-3、4k-1 都是固定的。如果你想算另一个类似的级数,就得手写一个新函数。
make_adder 是可配置的——你给不同的 n,它造出不同的函数:
add3 = make_adder(3)   # 造出 k+3
add5 = make_adder(5)   # 造出 k+5
add100 = make_adder(100)  # 造出 k+100

summation(1000, add3)    # 算 1000 项,每项 k+3
summation(1000, add5)    # 算 1000 项,每项 k+5
summation(1000, add100)  # 算 1000 项,每项 k+100
pi_term 是"一个函数干一件事",make_adder 是"一个函数干一类事"——这就是为什么讲完 summation 要接着讲 make_adder:summation 需要吃 term,而 make_adder 是批量生产 term 的工厂。

 能力图谱

